 SEO-Audit
Erreicht die KI-Suche
die Website deines Kunden?
Ein Crawl der eigenen Website des Kunden, der mit der KI-Suche beginnt: Welche KI-Crawler lassen robots.txt und Firewall durch, welche zitierten Seiten sind defekt, was liest ein Crawler im HTML? Danach die klassischen SEO-Prüfungen, jedes Problem sortiert danach, was die betroffenen Seiten wert sind.
Seiten sind im Tarif enthalten: pro Seite wird nichts berechnet, und es gibt keine Mehrkosten. Das Audit liest das HTML, das dein Server liefert, und führt kein JavaScript aus.
Erst die KI-Suche, dann der Rest
Die meisten Audit-Tools beginnen mit Titeln und defekten Links. Dieses beginnt mit der Frage, ob die KI-Suche die Website erreichen und lesen kann.
Zugang für KI-Crawler, getestet
Die robots.txt wird Seite für Seite gegen die KI-Suchcrawler und KI-Fetcher geprüft. Dann ruft das Audit die Startseite einmal mit dem veröffentlichten User-Agent jedes der 8 KI-Crawler auf. So fällt eine Firewall oder ein CDN auf, das einen Crawler abweist, den die robots.txt erlaubt. Eine Abweisung wird als Abweisung gemeldet, mit der Schicht, wenn sie sich benennen lässt. Mit angebundenen Server-Logs zeigt es außerdem, wo verifizierte KI-Crawler in den letzten 14 Tagen abgewiesen wurden.
Seiten, die KI-Antworten zitieren
Eine Seite, die KI-Antworten in den letzten 30 Tagen zitiert haben und die jetzt einen Fehler liefert, weiterleitet, auf noindex steht oder per robots.txt gesperrt ist, steht ganz oben. Voraussetzung ist die KI-Sichtbarkeits-Beobachtung für den Kunden.
Was ein Crawler im HTML liest
Seiten mit kaum Text im HTML, eine leere App-Hülle, nosnippet-Anweisungen, versteckte Anweisungen an KI-Systeme, fehlende strukturierte Daten auf Schlüsselseiten, eine fehlende oder defekte llms.txt und die Frage, ob Seiten eine Markdown-Fassung anbieten.
Sortiert nach dem Wert der Seiten
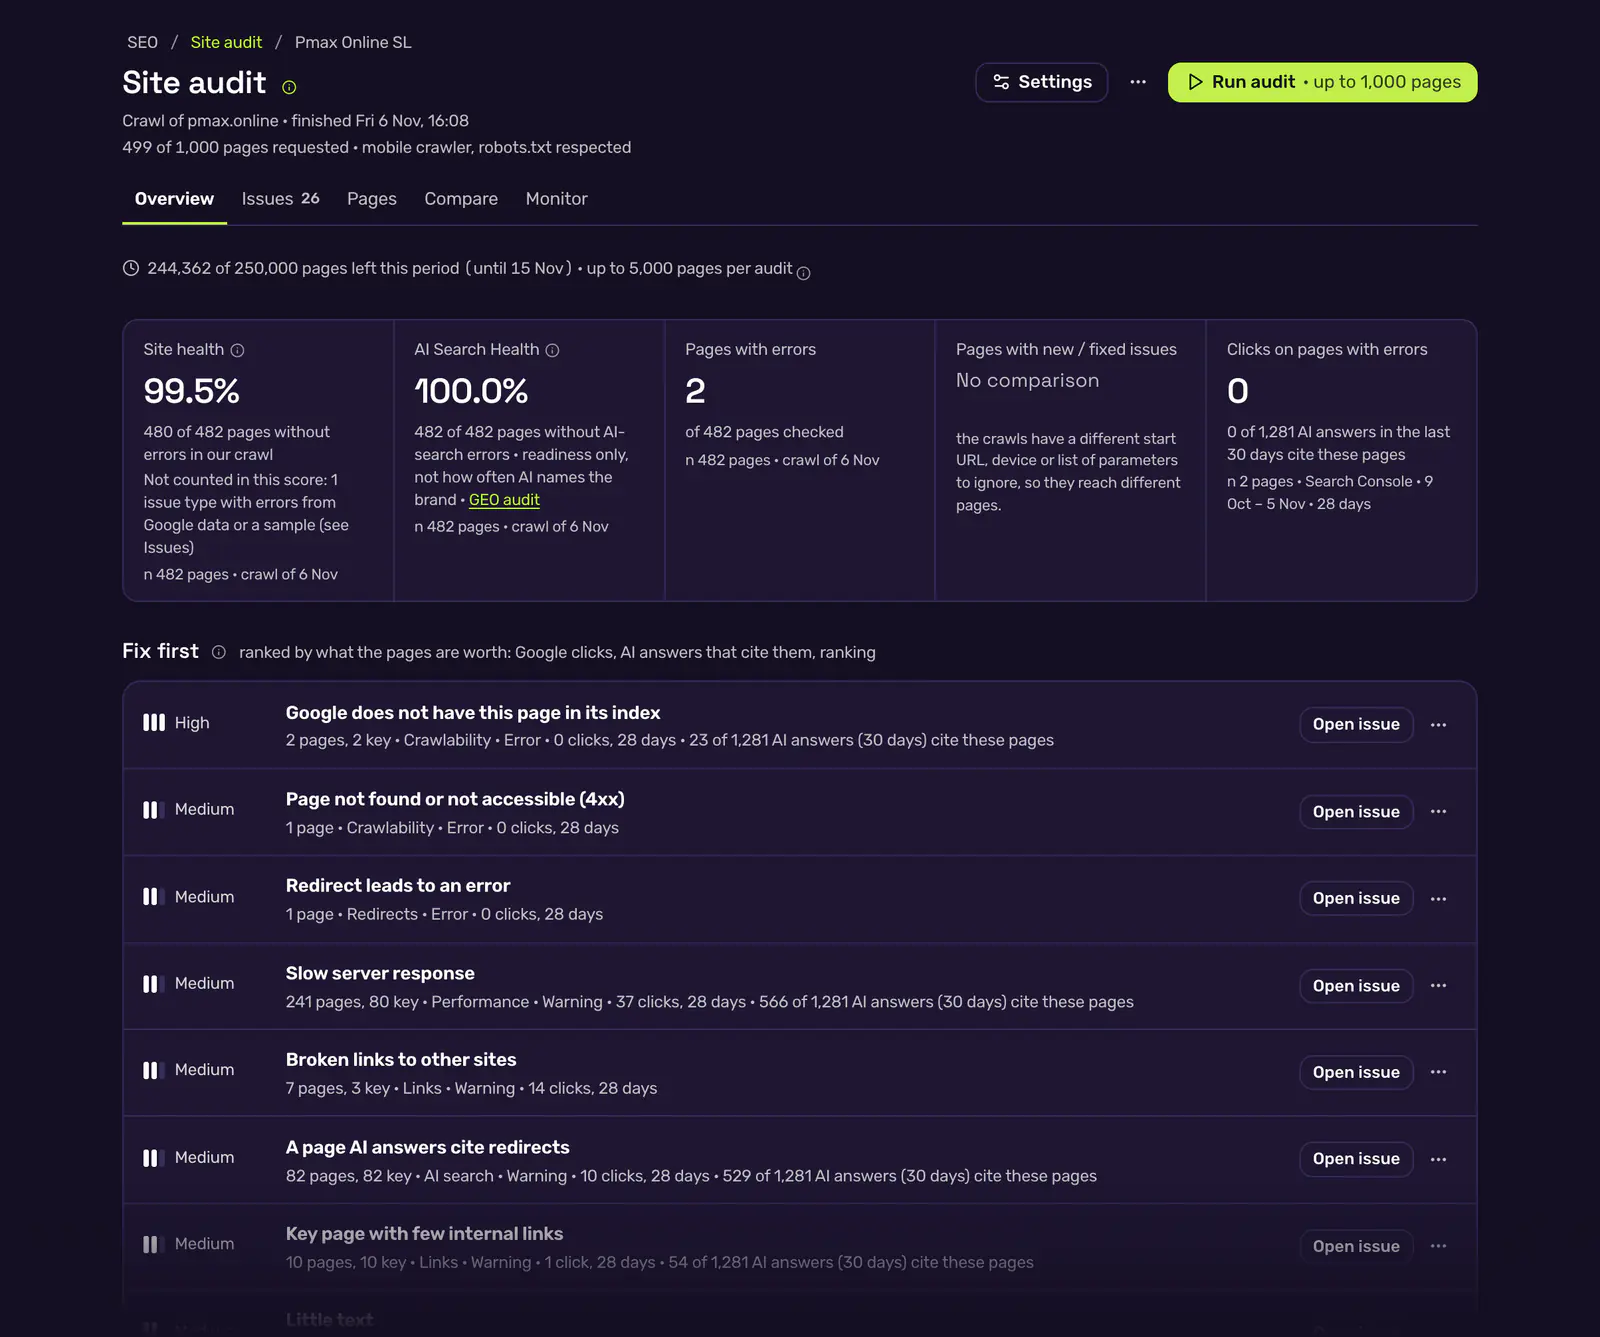
Jede Seite bekommt eine Wertstufe aus ihren Google-Klicks (Search Console, 28 Tage), den KI-Antworten, die sie zitieren (30 Tage), und den Rankings beobachteter Keywords. Probleme werden nach Priorität sortiert, dann nach Klicks, dann nach Seiten. Die Zahlen beschreiben die betroffenen Seiten; sie versprechen nie, was eine Lösung zurückbringt.
Zwei Werte, nie gemittelt
Site Health und AI Search Health sind jeweils die Seiten ohne Fehler an den bewerteten Seiten, mit beiden Zahlen und dem Datum des Crawls. Eine Seite, die wir nicht messen konnten, ist nicht bewertet, und Hinweise bewegen keinen Wert.
Jede Prüfung zeigt ihre Grundlage
Jede der 189 Prüfungen sagt, ob sie auf einem Standard, der Dokumentation einer Plattform, einer entstehenden Konvention oder einer Heuristik beruht, und verlinkt ihre Quelle. Korrekte Konfiguration ist nie ein Befund, und eine Prüfung, die nicht laufen konnte, sagt das, statt zu bestehen.
Das klassische SEO-Audit ist auch dabei
Statuscodes und Weiterleitungsketten, Canonical-Tags, Titel und Meta-Beschreibungen, Überschriften, interne Links, Sitemaps, strukturierte Daten, HTTPS und Zertifikate, doppelte Inhalte und Seitengewicht.
- Verwaiste Seiten, gefunden über Sitemaps, Search Console, GA4 und KI-Crawler-Logs, nicht nur über den Crawl.
- Googles eigenes Urteil zu den wertvollsten Seiten (URL-Prüfung), wenn die Search Console verbunden ist.
- Hreflang wird nur bei Websites mit mehr als einer Sprache bewertet: Eine einsprachige Website wird nie dafür bemängelt, dass es fehlt.
Die Seiten, die KI-Antworten zitieren, und was sie kaputt macht
Jedes Problem listet die betroffenen Seiten mit ihren Google-Klicks und den gemessenen KI-Antworten, die sie zitieren, sagt, warum es zählt und wie du es behebst, und verlinkt die Quelle der Regel. Lass Crunch den Fix entwerfen, mach eine Aufgabe daraus oder blende es aus.
- Seiten sortiert nach den KI-Antworten und Klicks, die an ihnen hängen
- Jede Regel mit Quelle: ein Standard oder die Doku der Plattform selbst
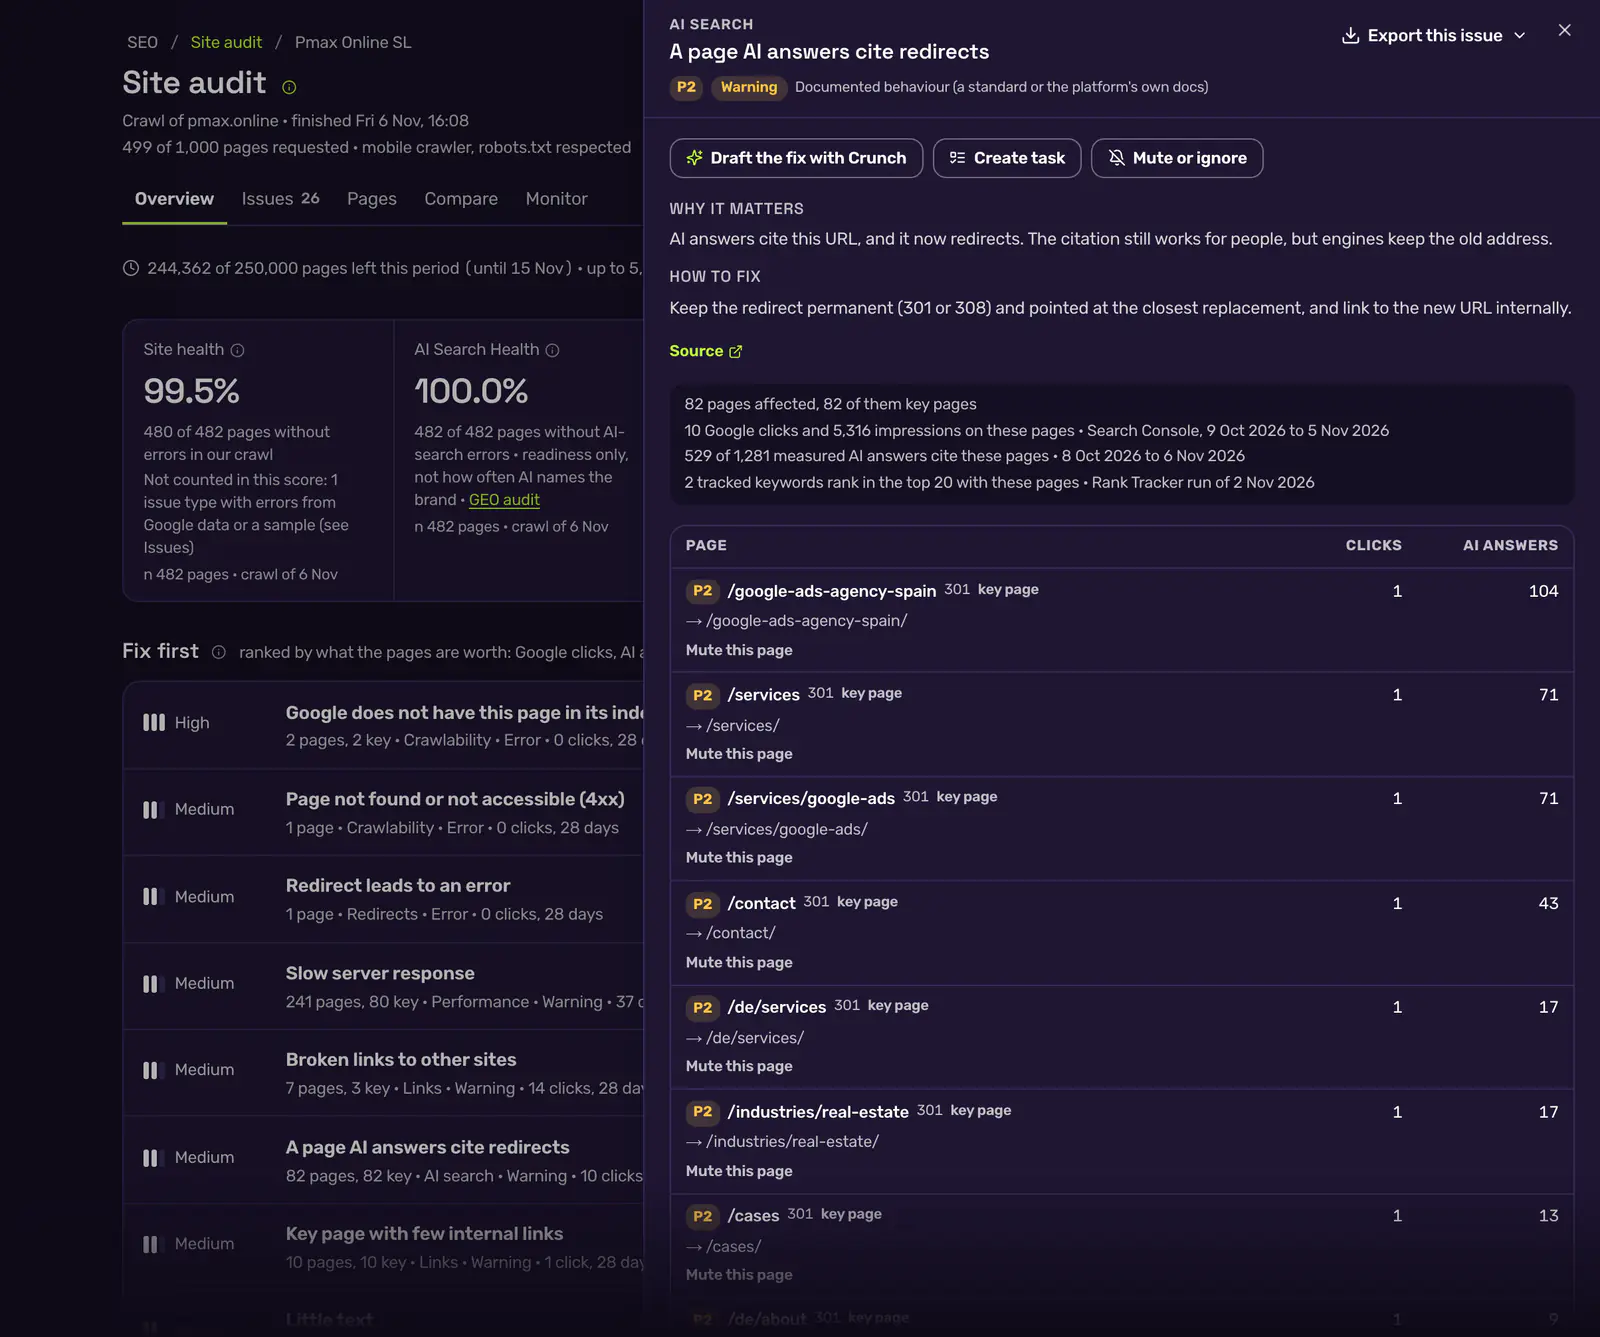
Vom Befund zur Lösung
Das Audit sitzt in dem Workspace, den die Agentur ohnehin nutzt, ein Befund endet also nicht in einem PDF.
Crawl gegen Crawl
Neue, behobene und offene Probleme zwischen zwei Crawls, nur wenn beide denselben Umfang hatten. Behoben heißt: erneut geprüft und bestanden.
Signale statt noch eines Dashboards
Nach einem Crawl kann das Audit Signale mit beiden Daten und den bewerteten Seiten auslösen: neue Fehler auf Schlüsselseiten, ein Rückgang der Site Health, ein gesperrter KI-Crawler, eine zitierte Seite, die kaputtging. Automationen können darauf reagieren.
Aufgaben und entworfene Lösungen
Mache aus einem Problem eine Aufgabe in den Freigaben, mit Zuständigem und Fälligkeit. „Lösung mit Crunch entwerfen“ schreibt das Tag, den JSON-LD-Block, die robots.txt-Zeilen oder die Weiterleitungsregel für ein Problem auf einer Seite, aus dem, was der Crawl gespeichert hat, und nur auf Klick.
Im Kundenbericht
Site Health, AI Search Health, die wichtigsten Probleme und der Zugang für KI-Crawler sind eine Berichtsquelle im Builder, auf einem Freigabe-Link und im PDF, unter der Marke der Agentur.
Aus deinem Assistenten
12 MCP-Tools lesen das Audit, vergleichen Crawls, ändern Einstellungen, schalten Probleme stumm und legen Aufgaben an. Einen Crawl zu starten, steht hinter derselben Freigabe wie Aktionen, die KI verbrauchen.
In vier Sprachen
Erklärung und Lösungshinweis jedes Problems sind von Grund auf auf Englisch, Deutsch, Spanisch und Französisch geschrieben.
Rücksichtsvoll gebaut
Der Crawler nennt sich CrunchJunkieSiteAudit, liest die robots.txt vor jeder Seite und befolgt sie, ohne Ausnahme. Er sendet höchstens eine Anfrage pro Sekunde, befolgt ein Crawl-delay von bis zu 10 Sekunden und hält an, wenn die Website mehr als 20 % der letzten Anfragen abweist oder die robots.txt mit einem Serverfehler beantwortet.
So erlaubst oder sperrst du unseren Crawler- Er crawlt nur die Website, die zum Kunden gehört, nachdem jemand bestätigt hat, dass er sie prüfen darf. Nie die eines Wettbewerbers.
- Er speichert, was ein Audit braucht (Statuscodes, Titel, Links), nicht den Text der Seiten. Die Crawls laufen von Frankfurt aus auf unserer EU-Infrastruktur.
- Eine Seite, die die Firewall abweist, wird als abgewiesen gemeldet, nie als defekt.
Seiten sind in deinem Tarif enthalten
Jeder Workspace hat pro Abrechnungszeitraum ein Seitenkontingent, das sich alle seine Kunden teilen. Eine Seite zählt, wenn der Crawler sie abruft; per robots.txt gesperrte Seiten, Bilder, Skripte und Tests zählen nicht. Pro Seite wird nichts berechnet und es gibt keine Mehrkosten: Ein Crawl, der nicht in das verbleibende Kontingent passt, startet nicht.
| Tarif | Seiten pro Monat | Seiten pro Crawl |
|---|---|---|
| Solo | 5.000 | 1.000 |
| Starter | 25.000 | 5.000 |
| Pro | 100.000 | 5.000 |
| Agency | 250.000 | 5.000 |
| Scale | 1.000.000 | 5.000 |
| Test | 1.000 | 500 |
Seiten pro Crawl ist das Meiste, was ein Crawl abrufen kann. Scale wird individuell berechnet; seine Zeile ist das Standardkontingent.
Was es nicht kann
Ein Crawl ruft höchstens 5.000 Seiten ab, und ein Kunde kann 5-mal pro Tag (UTC) geprüft werden. Es liest das HTML, das dein Server liefert, und führt kein JavaScript aus; Text, der erst nach dem Ausführen von Skripten erscheint, gilt deshalb als fehlend. Es prüft nur die eigene Website des Kunden, nie die eines Wettbewerbers. Es schätzt nicht, was eine Lösung bei Rankings oder Traffic zurückbringt. Prüfungen zur Barrierefreiheit und die AMP-Validierung sind nicht enthalten.
Fragen vor dem ersten Crawl
Betreibe es neben den KI-Sichtbarkeits-Werten desselben Kunden: KI-Sichtbarkeit
Sieh, was die KI-Suche auf den Websites deiner Kunden sieht
Starte das erste Audit schon im Test. Seiten sind enthalten; beim ersten Lauf bestätigst du, dass du die Website prüfen darfst.
In jedem Tarif enthalten · pro Seite nichts berechnet · liest das HTML, das dein Server liefert